DeepInfer - 面向DeepSeek-V4.1-Flash的开源大模型推理框架
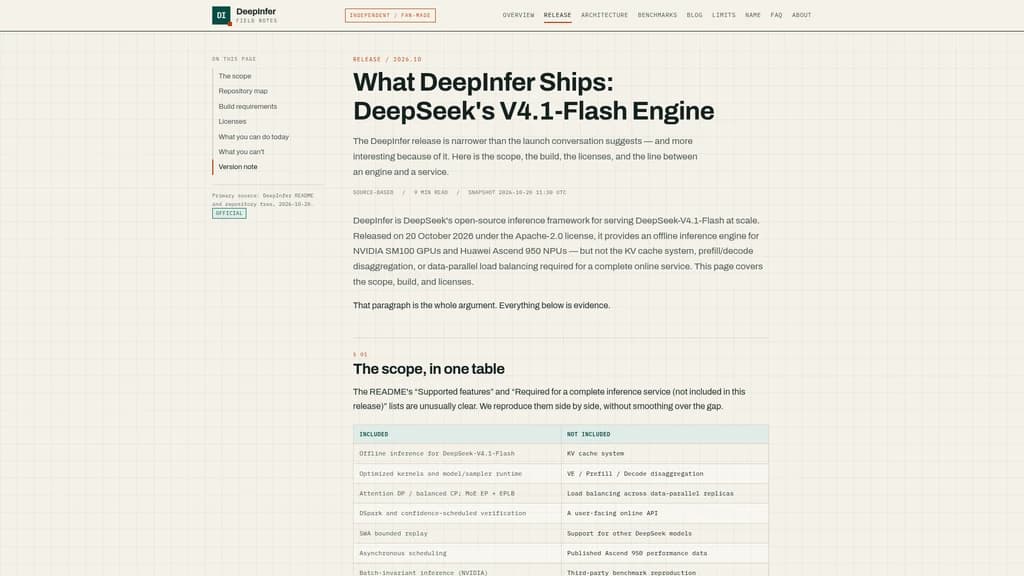
上线于 2026年10月20日DeepInfer是深度求索推出的采用Apache 2.0许可的离线推理引擎,用于大规模部署DeepSeek-V4.1-Flash。它在Linux系统上支持NVIDIA SM100与华为昇腾950硬件,内置优化内核、专家并行、投机解码与确定性采样功能。该工具面向使用DeepSeek-V4.1-Flash的开发者、推理引擎研究人员以及搭建自定义大模型服务基础设施的工程师,并非完整的服务栈、面向终端用户的API或适配其他模型的通用推理引擎。
DeepInfer
DeepInfer 是深度求索(DeepSeek)开源的 Apache-2.0 许可离线推理框架,专为大规模部署 DeepSeek-V4.1-Flash 而构建。它支持运行在 Linux 系统上的 NVIDIA SM100 与华为昇腾 950 硬件,相关文档由独立爱好者制作的参考站点提供,覆盖发布细节、架构设计、基准测试注意事项以及未包含的组件。该工具不是托管 API、面向用户的在线服务,也不是完整的端到端服务栈。
核心能力
DeepInfer 预装了一整套为 DeepSeek-V4.1-Flash 定制优化的组件:
一整套自定义内核,包括 FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect 以及自定义 TileLang 内核,由 DeepSeek 此前发布的内核组件整合为统一引擎。
并行配置融合了用于 MoE 层的专家并行(EP)、注意力数据并行(DP)与均衡上下文并行(CP),设计用于在生产部署中将专家分布到 64–128 张 GPU 上,同时设置冗余副本以重新平衡热门专家。
支持可变验证的 DSpark 投机解码,通过置信度头识别哪些草稿令牌需要经过完整模型验证,在标准生产运行条件下可实现 4–7% 的吞吐量提升。
滑动窗口注意力(SWA)有界重放,仅重放缓存的近期尾部内容而非在每一层重建完整滑动窗口缓存,以此限制重计算开销,获得可预测的有界计算成本。
异步调度机制,将 CPU 批次准备工作与 GPU 运行并行执行,消除连续解码步骤之间的空闲间隙。
仅在 NVIDIA 硬件上提供批次不变推理与确定性采样模式,用于可审计的基准测试与一致的智能体运行行为。
原生支持正则表达式规则、JSON Schema 定义与 EBNF 语法约束的结构化输出。
配套的
deepseek-recipe库是独立的 MIT 许可仓库,提供 API 协议转换与分词工具。完整支持 DeepSeek-V4.1-Flash 模型的离线推理执行。
目标用户
DeepInfer 面向三类主要用户群体:
直接使用 DeepSeek-V4.1-Flash 模型、需要对推理执行进行底层控制的开发者。
研究生产级大语言模型优化模式的推理引擎研究者,研究方向包括宽范围专家并行、置信度引导投机解码与有界缓存重放。
搭建自定义大语言模型服务基础设施的工程师,希望将 DeepSeek 源自生产环境的推理优化方案适配到自己的部署中。
支持的工作流
该框架专为 DeepSeek-V4.1-Flash 的离线推理负载设计,没有预装面向用户的服务层。典型使用模式包括:
将预优化的内核栈与并行配置集成到面向 DeepSeek-V4.1-Flash 的自定义内部推理流水线中。
在 NVIDIA 硬件上测试与审计确定性推理行为,用于基准测试或智能体负载。
为 DeepSeek-V4.1-Flash 负载实现结构化输出约束,无需额外第三方中间件。
扩展基础引擎,为特定内部基础设施需求搭建自定义服务组件。
研究并修改前沿大语言模型推理优化方案,包括投机解码与 MoE 负载均衡。
限制与明确未包含的功能
DeepInfer 的适用范围有明确限定,不包含完整生产在线服务栈所需的部分组件:
不包含可跨独立请求或多机持久留存的 KV 缓存系统。
未实现预填充/解码分离机制以将负载拆分到独立的专用硬件池。
不支持跨多推理副本的数据并行负载均衡。
它不是面向用户的在线 API,未附带兼容 OpenAI 的服务器、身份验证、配额管理、计费或可观测性工具。
它不是通用推理引擎,仅支持 DeepSeek-V4.1-Flash 模型,官方不支持其他 DeepSeek 模型或第三方大语言模型。
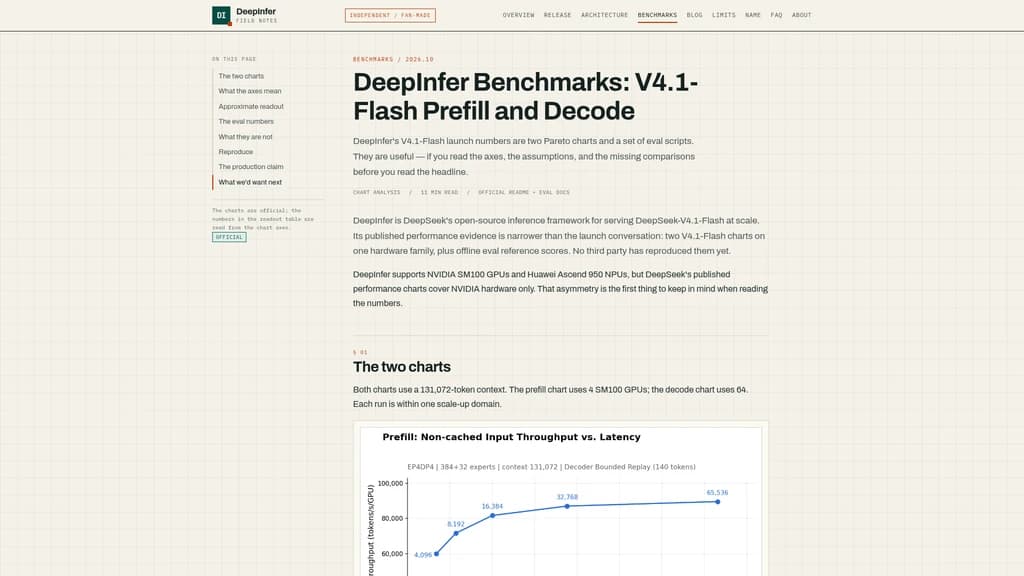
发布时暂未公开华为昇腾 950 硬件的性能数据。
截至 2026-10-20 的发布快照,尚未有第三方独立复现官方基准测试图表的公开结果。
所有官方基准测试数据均在 131072 令牌上下文长度下测得,而非 DeepSeek-V4.1-Flash 支持的最大 1M 令牌完整上下文;公开的解码性能数值基于 75% 的草稿令牌接受率,该数值会随输入文本复杂度变化。
该框架仅支持 Linux 上的 NVIDIA SM100 与华为昇腾 950 硬件,官方不支持其他代际的 NVIDIA 显卡或昇腾芯片。
许可与获取方式
DeepInfer 在宽松的 Apache-2.0 许可下发布,可免费下载、修改与自托管,无直接相关费用。配套的 deepseek-recipe 库在 MIT 许可下发布。覆盖该项目的独立爱好者参考站点与 DeepSeek、NVIDIA 或华为无关联,参考站点上的所有产品声明均直接引自公开官方来源。
相关内容
APIMart
APIMart是一款统一AI API聚合平台,通过单个兼容OpenAI的API即可接入500余款覆盖对话、图像、视频、音频场景的AI模型。平台将API密钥管理、统一计费、监控与生产级访问能力整合至同一控制台,简化运维流程。它支持感知服务健康状态的服务商路由与故障转移以提升稳定性,支持从现有OpenAI SDK完成一行代码迁移,面向开发AI应用的开发者与落地AI功能的团队,帮助其降低运维复杂度与使用成本。
FreeTheAI
FreeTheAI 是一个提供优质模型的免费 AI API:一个兼容 OpenAI 的密钥即可使用 80 多个模型,包括 GLM 5.3、Kimi K3 和 MiniMax M3,可在 JanitorAI、SillyTavern、Cursor 和 Claude Code 中使用。免费版每天提供 50 次请求,无需信用卡。每月 2 美元起的付费套餐即将推出,FreeTheAI 正在发展为一个 AI API 市场,一个余额即可使用众多提供商的模型。
SubmitMyStartup
SubmitMyStartup 是面向创业者的工具,帮你找到合适的渠道提交自己的创业项目。你可以把它的 MCP 服务端接入 Claude 或 ChatGPT,直接询问项目该去哪里发布;也可以用规划工具筛选出短名单,或是直接调用 JSON API。工具背后是一份免费的公开清单,收录了创业项目目录、发布渠道目录、SaaS 产品目录以及 Product Hunt 替代平台,所有条目都附带真实提交结果:包括每个渠道是否真的免费、有什么隐藏限制、收费标准和审核等待时长。全程只读,无需登录。
DecisionsApi
DecisionsApi 是面向开发者的 API 平台,用户只需通过统一接口,就能调用多个决策模型完成文本分类、评分和路由操作,专为需要结构化、可溯源AI输出的软件团队打造,用于路由、分类和决策自动化场景,不需要处理无结构的生成文本。用户可以在在线沙盒中免费测试所有工作流,之后再把相同的工作流直接对接自己的后端系统。
评论