


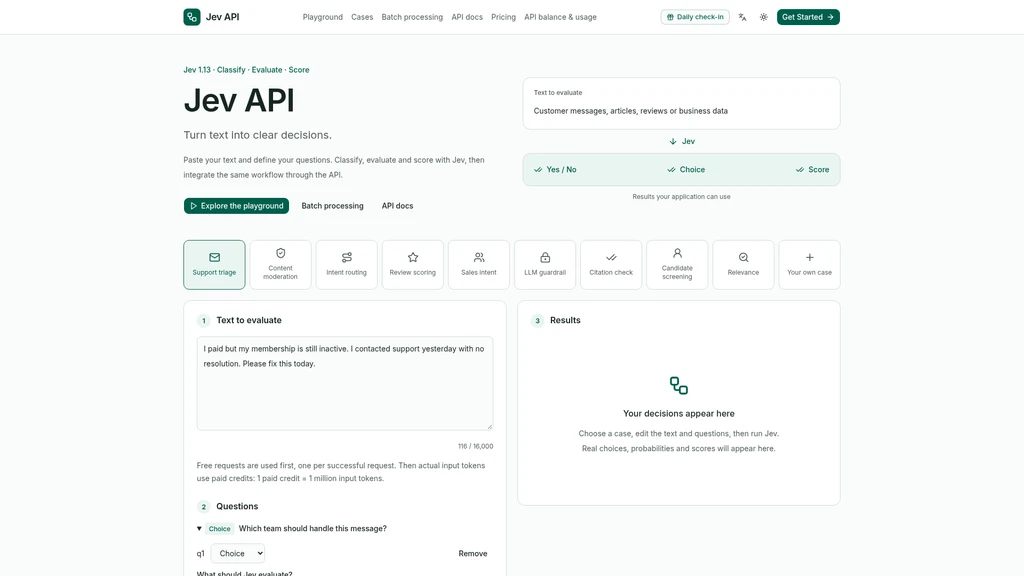
Jev by Jevapi - Transformez du texte en décisions de classification, d’évaluation et de notation claires et exploitables
Lancé le 28 sept. 2026Jev est un outil de traitement de texte qui permet aux utilisateurs de classer, évaluer et noter tout contenu textuel : messages clients, articles, avis, données professionnelles. Il prend en charge les contrôles oui/non personnalisés, la classification multi-étiquettes et la notation numérique, et propose une API publique pour intégrer ces Workflows directement dans des applications externes.
Contenu connexe

Copy.ai Review 2026: AI Copywriting Made Easy
Our honest Copy.ai review for 2026. We test Content Agents, AI Workflows, pricing ($29-$249/mo), and compare it to Jasper and Writesonic. Find out if it's worth it for your marketing team.

Rytr Review 2026: Is This Budget AI Writer Worth It?
Our hands-on Rytr review for 2026. We test features, pricing, content quality, and compare it to Jasper & ChatGPT. Find out if Rytr is the best budget AI writing tool.

Word Changer - Free AI tool to rewrite and improve your writing instantly
Writing always using repetitive words or need to avoid plagiarism? Word Changer is a free AI writing assistant that instantly rewrites any text with richer vocabulary and appropriate tone. Get multiple versions with one click, adjust formality level, check readability - all for free!

Unite - AI-powered platform for romantic fantasies and dream couple moments
Explore romantic fantasies and create special moments for your dream couple. This AI-powered platform lets you generate personalized romantic content and experience exclusive AI-created romantic experiences.
Commentaires