DeepInfer
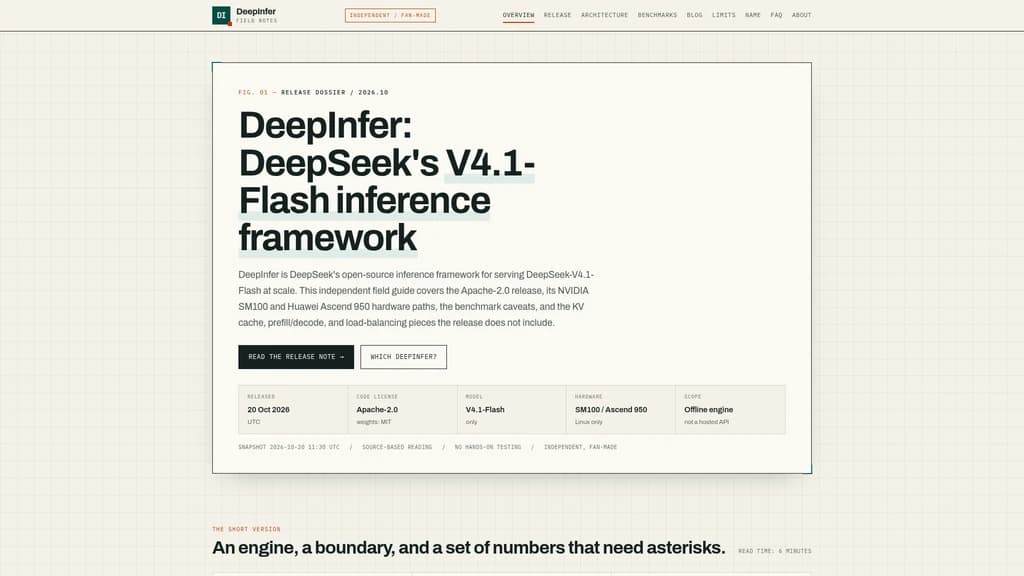
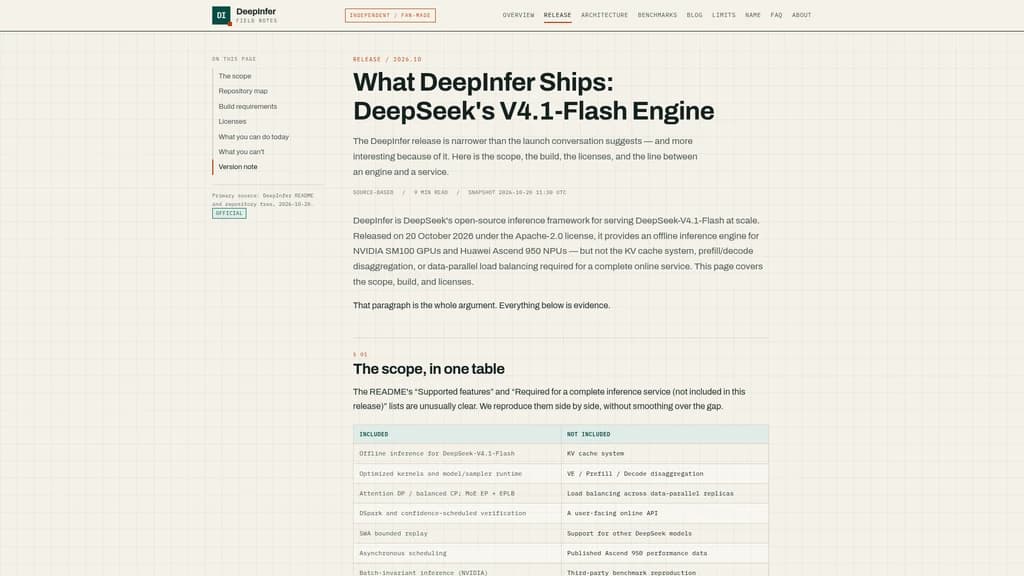
DeepInfer es el marco de inferencia sin conexión de código abierto de DeepSeek con licencia Apache-2.0, diseñado para ejecutar DeepSeek-V4.1-Flash a escala. Es compatible con el hardware NVIDIA SM100 y Huawei Ascend 950 que funciona en Linux, y su documentación se aloja en un sitio de referencia independiente creado por la comunidad que cubre los detalles de lanzamiento, la arquitectura, las advertencias de los puntos de referencia y los componentes no incluidos. Esta herramienta no es una API alojada, un servicio en línea orientado al usuario ni una pila de servicio completa de extremo a extremo.
Capacidades principales
DeepInfer se distribuye con una pila preintegrada de componentes optimizados creados específicamente para DeepSeek-V4.1-Flash:
Un conjunto completo de kernels personalizados que incluye FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect y kernels TileLang personalizados, ensamblados a partir de componentes de kernels de DeepSeek publicados anteriormente en un solo motor unificado.
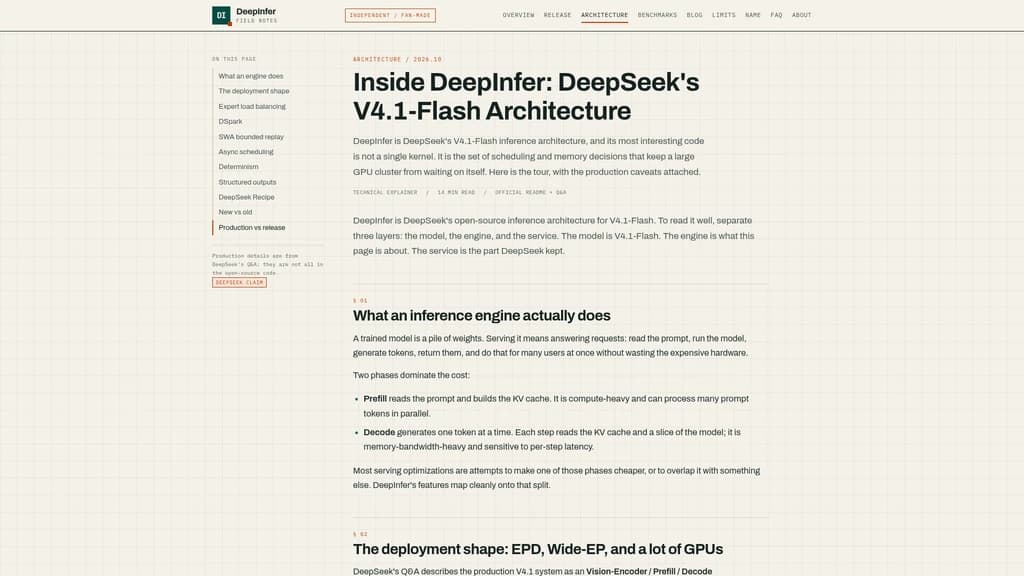
Una configuración de paralelismo que combina el paralelismo de expertos (EP) para capas MoE, el paralelismo de datos de atención (DP) y el paralelismo de contexto equilibrado (CP), diseñada para distribuir expertos entre 64 y 128 GPU en implementaciones de producción con copias redundantes para reequilibrar los expertos con mayor demanda.
Decodificación especulativa DSpark con verificación variable, que utiliza una cabeza de confianza para identificar qué tokens de borrador requieren la validación completa del modelo, lo que ofrece un aumento de rendimiento reportado del 4 al 7 % en los puntos de operación estándar de producción.
Reproducción limitada de atención de ventana deslizante (SWA), que limita el costo de recálculo al reproducir solo la cola reciente de la caché en lugar de reconstruir la caché de ventana deslizante completa en cada capa, para obtener una sobrecarga de cómputo predecible y limitada.
Programación asincrónica que ejecuta el trabajo de preparación de lotes de CPU en paralelo con la ejecución activa de GPU, eliminando los espacios de inactividad entre pasos de decodificación consecutivos.
Modos de inferencia invariables por lote y muestreo determinista disponibles exclusivamente en hardware NVIDIA, para la realización de puntos de referencia auditables y un comportamiento de ejecución de agentes consistente.
Compatibilidad nativa con salidas estructuradas para reglas de expresiones regulares, definiciones de esquemas JSON y restricciones de gramática EBNF.
La biblioteca complementaria deepseek-recipe, un repositorio separado con licencia MIT que proporciona conversión de protocolos de API y utilidades de tokenización.
Ejecución de inferencia sin conexión completa para el modelo DeepSeek-V4.1-Flash.
Públicos objetivo
DeepInfer está diseñado para tres grupos de usuarios principales:
Desarrolladores que trabajan directamente con el modelo DeepSeek-V4.1-Flash y que necesitan un control de bajo nivel sobre la ejecución de la inferencia.
Investigadores de motores de inferencia que estudian patrones de optimización de LLM de grado de producción, incluido el paralelismo amplio de expertos, la decodificación especulativa guiada por confianza y la reproducción limitada de caché.
Ingenieros que crean infraestructuras personalizadas de servicio de LLM y que desean adaptar las optimizaciones de inferencia derivadas de la producción de DeepSeek para sus propias implementaciones.
Flujos de trabajo compatibles
El marco está diseñado para cargas de trabajo de inferencia sin conexión centradas en DeepSeek-V4.1-Flash, sin una capa de servicio orientada al usuario preconstruida. Los patrones de uso típicos incluyen:
Integrar la pila de kernels preoptimizados y la configuración de paralelismo en canalizaciones de inferencia internas personalizadas para DeepSeek-V4.1-Flash.
Probar y auditar el comportamiento de inferencia determinista para cargas de trabajo de puntos de referencia o agentes en hardware NVIDIA.
Implementar restricciones de salida estructurada para cargas de trabajo de DeepSeek-V4.1-Flash sin middleware de terceros adicional.
Extender el motor base para crear componentes de servicio personalizados para requisitos específicos de infraestructura interna.
Investigar y modificar optimizaciones de vanguardia de inferencia de LLM, incluida la decodificación especulativa y el equilibrio de carga de MoE.
Limitaciones y funciones explícitamente no incluidas
DeepInfer tiene un alcance definido y reducido, y no se distribuye con los componentes necesarios para una pila completa de servicio en línea de producción:
No incluye un sistema de caché KV persistente que pueda sobrevivir a solicitudes separadas o a varias máquinas.
No implementa la desagregación de prellenado/decodificación para dividir las cargas de trabajo entre grupos de hardware dedicados separados.
No incluye el equilibrio de carga de datos paralelos entre varias réplicas de inferencia.
No es una API en línea orientada al usuario, y no se distribuye con un servidor compatible con OpenAI, autenticación, gestión de cuotas, facturación ni herramientas de observabilidad.
No es un motor de inferencia de propósito general, y solo es compatible con el modelo DeepSeek-V4.1-Flash, sin soporte oficial para otros modelos de DeepSeek ni LLM de terceros.
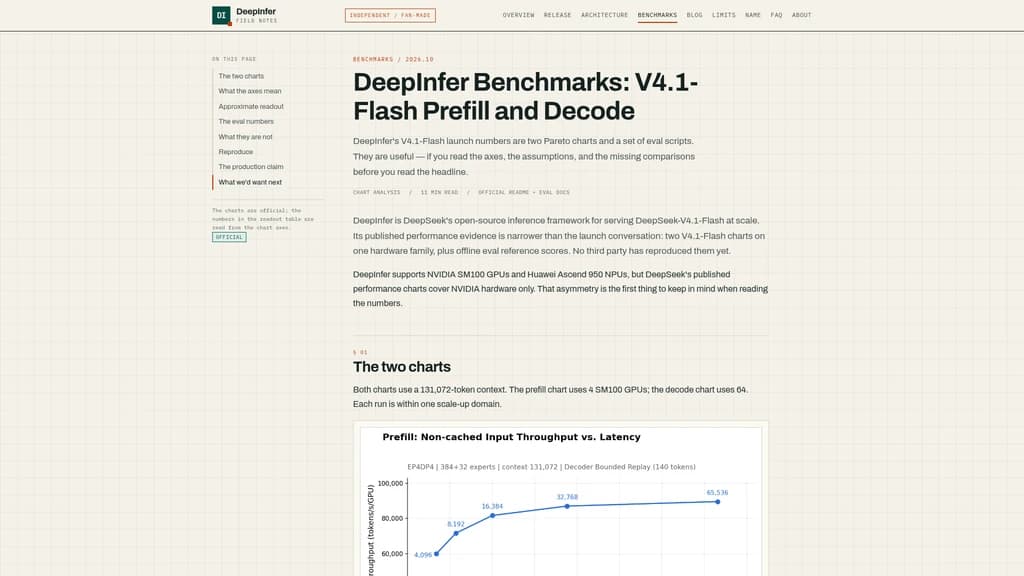
No hay datos de rendimiento publicados disponibles para el hardware Huawei Ascend 950 en el momento del lanzamiento.
No se han publicado reproducciones independientes de terceros de los gráficos de puntos de referencia oficiales a partir de la instantánea de lanzamiento del 20 de octubre de 2026.
Todos los datos de puntos de referencia oficiales se miden con una longitud de contexto de 131 072 tokens, no con el contexto máximo completo de 1 millón de tokens que admite el modelo DeepSeek-V4.1-Flash, y los números de rendimiento de decodificación publicados suponen una tasa de aceptación de tokens de borrador del 75 % que variará según la complejidad del texto de entrada.
El marco no admite ningún hardware fuera de NVIDIA SM100 y Huawei Ascend 950 en Linux, sin soporte oficial para otras generaciones de NVIDIA ni chips Ascend.
Licencia y acceso
DeepInfer se publica bajo la licencia permisiva Apache-2.0, y está disponible para su descarga, modificación y autohospedaje gratuitos sin costos directos asociados. La biblioteca complementaria deepseek-recipe se publica bajo la licencia MIT. El sitio de referencia independiente creado por la comunidad que cubre el proyecto no está afiliado a DeepSeek, NVIDIA ni Huawei, y todas las afirmaciones sobre productos en el sitio de referencia se atribuyen directamente a fuentes oficiales públicas.





Comentarios